La alfabetización estadística es la capacidad de comprender, interpretar y evaluar críticamente los datos y los argumentos estadísticos que aparecen en la vida diaria y en los medios de comunicación. Se trata de entender términos cotidianos como porcentajes, promedios, muestras representativas y variabilidad; Interpretar tablas, diagramas y figuras sin caer en confusiones por escalas engañosas; Cuestionar de dónde provienen los datos, quién los financia y si las conclusiones están bien respaldadas; Usar el sentido estocástico (la noción de probabilidad e incertidumbre) para actuar de forma informada ante riesgos o noticias falsas.
Para conocer qué países en el mundo llevan la delantera en materia de alfabetización estadística, generalmente se cruzan los datos de las pruebas PISA de la OCDE (jóvenes), el Programa PIAAC de la OCDE (adultos) y el Proyecto Internacional de Alfabetización Estadística (ISLP). El Programa para la Evaluación Internacional de los Estudiantes (PISA) resulta útil porque no solo mide la matemática abstracta, sino también la competencia matemática aplicada a la vida real, la cual incluye un bloque entero dedicado a la interpretación de datos, gráficos, probabilidades e incertidumbre. En este caso, los sistemas educativos del este asiático dominan de forma constante las primeras posiciones, de modo que Singapur, China, Japón y Taiwán suelen ocupar los puntajes más altos del mundo. Pero también países europeos como Finlandia, Estonia, Suiza o Canadá usualmente destacan por la capacidad de sus estudiantes para analizar críticamente la información cuantitativa.
El Programa para la Evaluación Internacional de las Competencias de los Adultos (PIAAC) evalúa las habilidades de la población de entre 16 y 65 años en áreas de “Numeracy” (competencia numérica avanzada) y resolución de problemas en entornos tecnológicos. Los resultados de esta evaluación revelan que Japón y Finlandia suelen encabezar la lista en las competencias de adultos para gestionar información numérica, tablas de datos y riesgos. Por su parte, el Proyecto Internacional de Alfabetización Estadística (ISLP) premia proyectos cooperativos y organiza competencias internacionales de pósteres estadísticos donde participan miles de estudiantes de decenas de países. Los países con fuertes oficinas nacionales de estadística, como Australia, Nueva Zelanda o ciertos países nórdicos, se consideran referentes debido a sus robustas campañas públicas de divulgación de datos reales.
Para México, en la subescala de Incertidumbre y datos de los recientemente publicados resultados de la prueba PISA, se observa que solo el 30% de los estudiantes mexicanos alcanza los niveles mínimos de competencia (Nivel 2), lo que significa que a la gran mayoría se le dificulta interpretar un gráfico estadístico básico, comparar distribuciones o resolver problemas elementales de probabilidad. En América Latina, incluso en los países mejor posicionados, como Chile o Uruguay, más del 50% de los jóvenes de 15 años se ubican por debajo del nivel mínimo de competencia en tareas de análisis de datos. En países del bloque bajo, esta cifra de exclusión cognitiva llega a superar el 80% de los estudiantes, exponiendo una seria dificultad regional para formar ciudadanos capaces de tomar decisiones informadas en la era del Big Data y la Inteligencia Artificial.
¿Por qué es tan importante la alfabetización estadística? Particularmente, una menor alfabetización estadística en el ámbito urbano tiene un impacto directo y negativo en la calidad de vida, la democracia local y la planificación de las ciudades. Porque cuando los ciudadanos, los líderes vecinales o los propios gestores públicos no comprenden los datos, las urbes sufren consecuencias costosas. Estas pueden suceder, por ejemplo, cuando un gobierno local justifica una obra pública costosa o innecesaria (como una autopista urbana) presentando gráficos con escalas distorsionadas, porcentajes engañosos o proyecciones de tráfico manipuladas. También, cuando la población no sabe interpretar un diagnóstico sociodemográfico o un análisis de costo-beneficio y las decisiones se toman por pura intuición, simpatía política o “la voz del que grita más fuerte”. Otro impacto negativo de la falta de alfabetización estadística se da cuando los ciudadanos no entienden cómo funcionan los datos estadísticos y ven los portales de datos abiertos de su municipalidad como herramientas inútiles o, peor aún, desconfiarán de ellos por teorías conspirativas sobre la vigilancia de datos.
Veamos algunos ejemplos. Los mapas de calor de delincuencia, es una de las herramientas visuales más utilizadas por las municipalidades y los medios de comunicación para justificar políticas de seguridad. Imaginemos entonces que una alcaldía presenta el siguiente mapa de su ciudad para alertar a los ciudadanos y planificar el patrullaje policial:
El Mapa Engañoso: “Puntos Calientes” de Robo de Autos
El mapa muestra una mancha de color rojo intenso (un “punto caliente” o hotspot) exactamente sobre el Barrio Centro de la ciudad, mientras que el Barrio Residencial Norte aparece en un color verde claro y pacífico. A simple vista, cualquier ciudadano o regidor sin alfabetización estadística concluirá: “El Centro es extremadamente peligroso para tener auto; hay que enviar a toda la policía allá y evitar esa zona”.
La Realidad Estadística (El Sesgo Oculto)
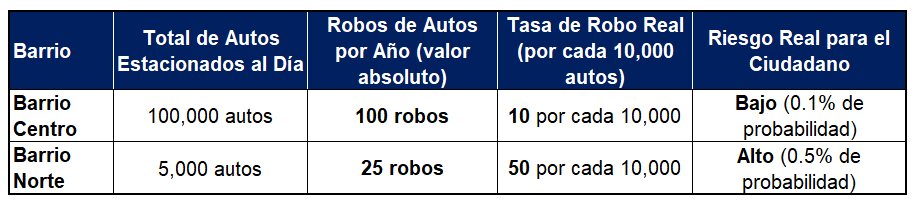
El mapa comete un error estadístico clásico: confundir números absolutos con tasas relativas ya que al mirar los datos reales detrás del gráfico, la situación cambia por completo:
¿Por qué el mapa miente sin alterar los números?
El mapa de calor cuenta cuántos robos ocurren por kilómetro cuadrado, no por la cantidad de autos expuestos. El Centro concentra miles de vehículos comerciales, de oficinas y de turistas; por lo tanto, lógicamente habrá más reportes de incidentes en total. Sin embargo, para un ciudadano que estaciona su vehículo, la probabilidad de sufrir un robo es 5 veces mayor en el Barrio Norte que en el Centro.
¿qué implicaciones tendría para la ciudad esta percepción errónea?
Si las autoridades locales y los vecinos toman decisiones basadas en la interpretación visual errónea de este mapa, se desperdiciarían recursos porque la policía concentrará sus patrullas en el Centro (donde el riesgo individual es bajo), dejando al Barrio Norte completamente desprotegido. Los negocios del Centro pueden perder clientes o ver caer el valor de sus propiedades debido a una “fama de peligrosidad” que estadísticamente está distorsionada. Pero, además, los residentes del norte vivirán bajo una falsa sensación de seguridad, descuidando alarmas o medidas de prevención que sus datos de riesgo real exigen.
Otro ejemplo se puede encontrar en los temas relacionados con el transporte urbano y la movilidad, en donde uno de los errores estadísticos más comunes ocurre al interpretar los “tiempos promedio de viaje”. Las ciudades suelen utilizar el promedio como la principal métrica para presumir si el tráfico mejoró o empeoró, pero este dato suele esconder realidades opuestas debido al sesgo de los valores atípicos (outliers).
El caso: La ampliación de la Avenida Central
Supongamos que el área de movilidad de una alcaldía decide agregar un tercer carril a una avenida principal para intentar reducir los embotellamientos en hora pico. Tras un año de obras, el secretario de transporte presenta con orgullo la estadística oficial: “Gracias al nuevo carril, el tiempo promedio de viaje en la avenida bajó de 40 a 30 minutos. ¡La obra fue un éxito rotundo!”. Pero sucede que cuando se desglosa la base de datos real (analizando la mediana y la distribución de los datos en lugar de solo el promedio), se descubre una trampa metodológica:
Los datos reales detrás del promedio
Supongamos que se mide el viaje de 10 ciudadanos bajo el escenario viejo y el escenario nuevo:
Escenario Viejo (10 personas en hora pico): El tráfico era pesado pero constante. Las 10 personas tardaban exactamente 40 minutos cada una. Cálculo del promedio: 40 x 1010=40 minutos
Escenario Nuevo (Ocurre la “Demanda Inducida”): El carril extra atrajo a muchos más automóviles. Ahora, la congestión empeoró drásticamente para la mayoría en la hora pico, elevando su tiempo a 50 minutos. Sin embargo, 2 personas pasaron en un horario de la madrugada (valores atípicos) donde la vía quedó completamente libre y tardaron solo 5 minutos.
Los 10 viajes reales: 50, 50, 50, 50, 50, 50, 50, 50, 5, 5.
Cálculo del promedio: 50 x 8+5 x 210=400+1010=31 minutos
¿Qué sucedió?
El promedio bajó notablemente (de 40 a 31 minutos), lo que da la ilusión de una mejora. Pero en la vida real, al 80% de los usuarios el viaje se le retrasó 10 minutos más. Los viajes ultra rápidos de la madrugada (los valores atípicos) arrastraron el promedio hacia abajo, enmascarando el fracaso de la obra pública en las horas que de verdad importan.
¿qué implicaciones tendría para la ciudad esta otra percepción errónea?
Cuando las ciudades se gestionan midiendo únicamente promedios sin alfabetización de datos, ocurren graves problemas de planificación, por lo que se gastan millones en ampliar avenidas basándose en promedios engañosos, cuando la estadística de transporte demuestra que construir más carriles solo atrae más autos a largo plazo (el tráfico colapsa igual o peor). Además, si el reporte de promedios dice que los autos van “más rápido”, el gobierno justificará no invertir en ciclovías, líneas de metro o en mejorar el transporte público. Para solucionar esta situación, una ciudadanía alfabetizada en estadística exigiría ver la mediana (el viaje del usuario del medio) o desglosar los tiempos estratificados por hora pico y hora valle, evitando que un promedio mal utilizado maquille la ineficiencia vial.
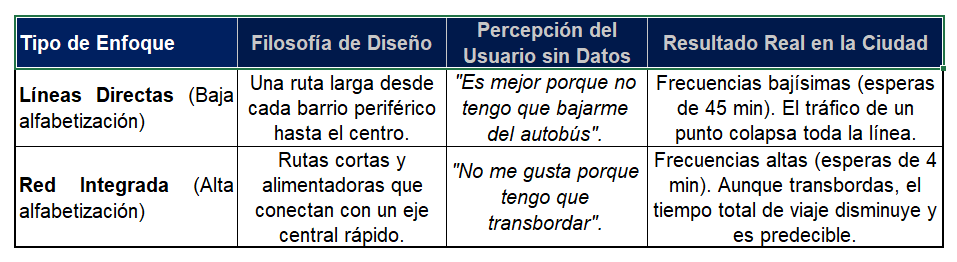
¿Otros ejemplos? El llamado Trampa de la “Ruta Escoba” que ocurre cuando en ciudades con baja alfabetización de datos se diseñan rutas de autobús que intentan pasar por la puerta de la casa de todos los vecinos. La ruta escoba termina siendo tan lenta y poco confiable que la gente prefiere comprar una motocicleta o usar aplicaciones de transporte privado. Una ciudadanía con cultura de datos entiende el balance: es estadísticamente mejor caminar 5 minutos hacia una vía troncal recta de alta frecuencia, que esperar 30 minutos a que pase un autobús lento frente a tu casa. Aunque existen muchos ejemplos más, termino refiriéndome a la optimización de transbordos. Trata de que en ciudades grandes, es matemáticamente imposible e ineficiente conectar cada barrio con todos los demás vecindarios mediante líneas directas. La solución óptima es un sistema de red transferible (donde bajas de un autobús rápido y subes a otro). Una población y un gobierno local con alfabetización estadística comprenden las ventajas de la probabilidad combinada: es más eficiente hacer un viaje de dos tramos con transbordo garantizado y rápido, que esperar una eternidad por un viaje directo que se quedará atrapado en el tráfico del otro extremo de la ciudad.
No me amplío más y solo preciso que para incrementar la alfabetización estadística de forma efectiva en una sociedad, los expertos y organismos internacionales coinciden en que no basta con enseñar fórmulas matemáticas tradicionales, sino que se requiere de un enfoque práctico y crítico estructurado. En la enseñanza básica esto pasa por sustituir ejercicios abstractos (como calcular la desviación estándar de una lista de números al azar) por proyectos reales, como analizar las estadísticas de uso de las redes sociales del propio salón de clases o los datos de contaminación de su ciudad. Es muy importante también, en la era digital y de la IA, centrar el esfuerzo educativo en la interpretación de los resultados más que en el cálculo de medidas o indicadores estadísticos. Es importante también la democratización de datos por parte de los gobiernos, lo que significa que las oficinas nacionales de estadística (como el INEGI en México, el INE en Chile o el DANE en Colombia) deben diseñar plataformas pensadas para el ciudadano común, no solo para economistas o científicos de datos. Es importante saber que la alfabetización estadística avanzada se correlaciona con países que poseen sistemas educativos enfocados en la resolución de problemas (más que en la memorización de fórmulas mecánicas) y una cultura de datos abierta.
Referencias
Córdoba Rojas, Kenneth (2026). “Más allá de los datos: alfabetización estadística, pensamiento crítico e inteligencia artificial en la educación contemporánea”. EDUCACIÓN MATEMÁTICA EN LAS AMÉRICAS. https://blog.ciaem-redumate.org/mas-alla-de-los-datos-alfabetizacion-estadistica-pensamiento-critico-e-inteligencia-artificial-en-la-educacion-contemporanea/
Nota: Para estructurar este análisis, el autor utilizó el modelo de IA Gemini (Google) como herramienta de apoyo para la búsqueda y contraste de información.


Comentarios
Antes de dejar un comentario pregúntate si beneficia a alguien y debes estar consciente en que al hacer uso de esta función te adíeles a nuestros términos y condiciones de uso.